L’AI può ordinare nomi incoerenti, proporre relazioni e individuare record sospetti. L’affidabilità dell’archivio dipende da provenienza, verifiche e incertezze rese visibili.
Due immagini disco possono avere nomi quasi identici e rappresentare release differenti. La stessa revisione può comparire sotto tre etichette, mentre una patch viene talvolta catalogata come se fosse un’edizione autonoma. In questo disordine l’AI offre il contributo più utile quando trasforma migliaia di elementi sparsi in una coda di verifiche comprensibile. La qualità finale nasce dalla struttura dei dati, dalla provenienza dichiarata e dalle decisioni documentate.
Prima della scheda viene il modello dei dati
Un catalogo retro tende ad appiattire entità diverse dentro un unico record. Titolo, edizione regionale, revisione, copia fisica e dump finiscono così per condividere campi che descrivono oggetti distinti. La confusione cresce quando entrano in gioco manuali, scansioni, patch, traduzioni e materiali promozionali.
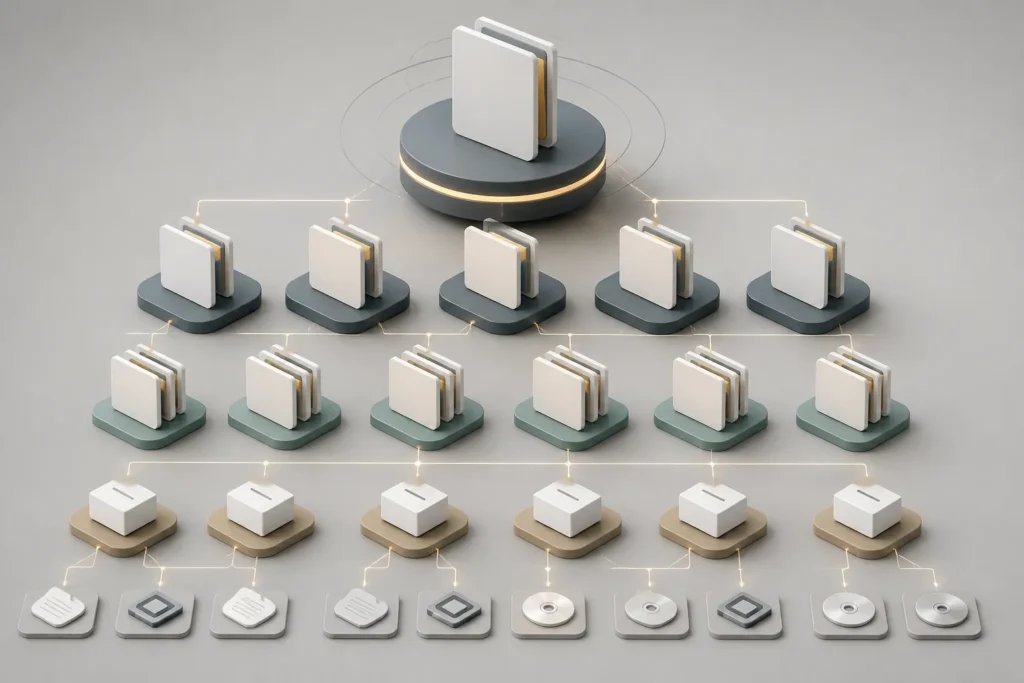
Una struttura più solida parte da livelli separati e collegati. Il gioco costituisce l’identità generale dell’opera. La release specifica piattaforma, territorio, lingua, editore e periodo di pubblicazione. La revisione descrive una variante del programma o dei dati. L’esemplare fisico registra le caratteristiche di una cartuccia, di un disco o della confezione osservata. Il file digitale conserva informazioni sul dump, sul formato e sull’integrità. Patch, manuali e immagini diventano oggetti correlati, ciascuno dotato della propria provenienza.
Questa distinzione risulta particolarmente utile per le piattaforme 32 e 64 bit, dove seriali regionali, ristampe economiche, edizioni multilingua e revisioni del supporto possono convivere sotto lo stesso titolo commerciale. Due file chiamati “PAL v1.1” potrebbero riferirsi a build diverse oppure allo stesso contenuto rinominato da persone differenti. L’AI può riconoscere la somiglianza linguistica e suggerire un collegamento. La conferma richiede il confronto tra seriale, struttura del supporto, dimensione, checksum e documentazione disponibile.
L’AI prepara ipotesi catalografiche
La prima attività adatta a un modello linguistico consiste nell’estrazione preliminare. Nomi di file, fogli di calcolo, note dei collaboratori e descrizioni testuali contengono spesso titoli, regioni, piattaforme, lingue e numeri di revisione in forme incoerenti. Un sistema assistito può ricondurre “PlayStation”, “PSX” e “PS1” a un termine controllato, conservando sempre la stringa originale da cui deriva la proposta.
La normalizzazione rende possibili operazioni successive. La ricerca semantica recupera record affini anche quando le parole usate divergono. La clusterizzazione riunisce duplicati probabili. L’estrazione di entità identifica sviluppatori, editori, persone e sistemi hardware citati nei documenti. Il confronto tra schede evidenzia campi incompatibili, come due territori assegnati allo stesso seriale o una data anteriore alla fonte che dovrebbe documentarla.
Ogni risultato automatico dovrebbe arrivare come proposta strutturata, accompagnata dal testo di origine, da un livello di confidenza e dai record coinvolti. Una frase fluida generata dal modello offre poca utilità operativa. Un campo candidato con evidenza associata permette invece al revisore di accettare, correggere o rinviare la decisione. Anche “dato assente” e “relazione incerta” sono valori informativi: impediscono a una lacuna di trasformarsi in una certezza apparente.
Le sperimentazioni della Library of Congress sulla descrizione computazionale e i casi d’uso pubblicati dal National Archives statunitense collocano l’AI in questo spazio di supporto: ricerca semantica, compilazione preliminare dei metadati e sintesi tematica. La documentazione professionale insiste inoltre sulla qualità del materiale di partenza e sul ruolo degli specialisti di dominio. Applicato al retro, lo specialista può essere un archivista, un redattore oppure un membro della community con esperienza documentata su una piattaforma.
Descrivere un gioco e preservare un file sono attività diverse
I metadati descrittivi aiutano a trovare e distinguere il materiale. Titolo, piattaforma, territorio, lingua, editore, genere e data permettono di navigare la collezione. I metadati di preservazione raccontano invece la storia operativa dell’oggetto digitale: provenienza, acquisizione, algoritmo usato per il checksum, verifiche d’integrità, software impiegato, conversioni e interventi successivi.
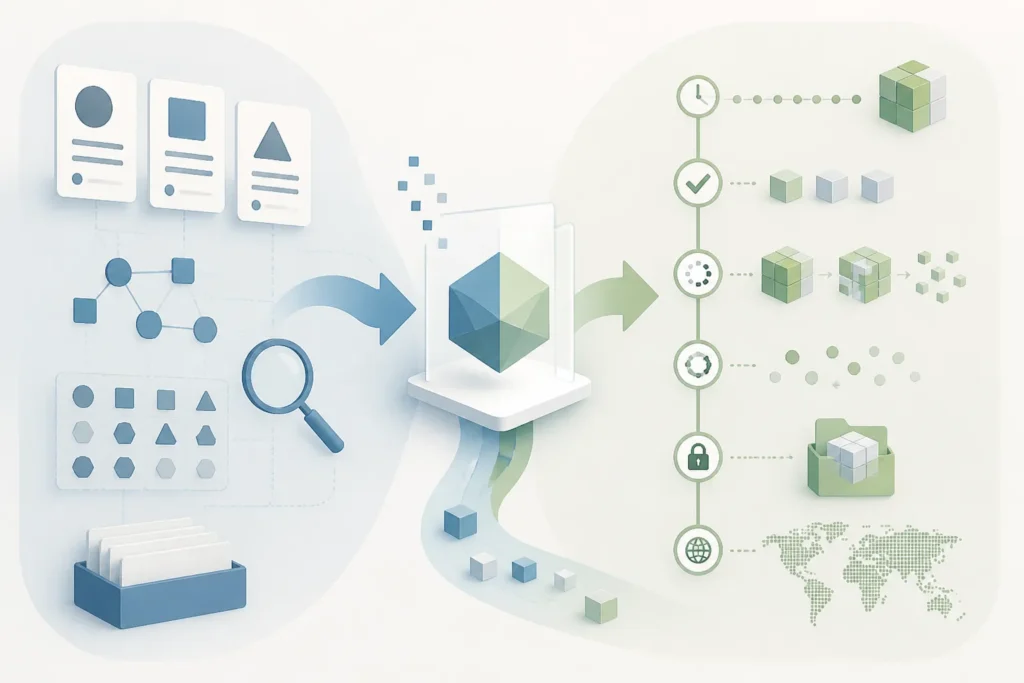
Lo standard PREMIS offre un vocabolario utile per organizzare questa seconda area attraverso oggetti, eventi, agenti e diritti. Un dump rappresenta un oggetto. Il calcolo di un checksum o l’applicazione di una patch costituiscono eventi. La persona o il programma responsabile vengono registrati come agenti. Le condizioni di accesso e utilizzo appartengono alla sfera dei diritti. Una community può adottare una versione semplificata di questo impianto, mantenendo intatta la logica della tracciabilità.
Il checksum identifica la sequenza di byte sottoposta al calcolo e consente controlli d’integrità nel tempo. L’identità storica richiede ulteriori elementi. Una traduzione applicata correttamente produce un digest diverso dal dump di partenza; entrambi meritano record separati e una relazione esplicita. La scheda della derivazione dovrebbe indicare patch, versione, file sorgente atteso, strumento utilizzato, autore dell’operazione e data. L’AI può confrontare readme, nomi dei pacchetti e valori registrati per suggerire queste relazioni. La verifica tecnica completa il collegamento.
La provenienza vale quanto il dato
Una scheda affidabile tratta ogni informazione come un’asserzione collegata a una fonte. La data riportata su un catalogo commerciale può divergere da quella presente nel manuale o nelle schermate del gioco. Il database conserva entrambe, specifica la natura delle fonti e registra quale valore viene adottato per la consultazione generale. In questo modo una futura scoperta può aggiornare la scheda lasciando leggibile il percorso precedente.
La verifica può avvenire anche a livello di singolo campo. Un record potrebbe avere seriale e regione confermati, data stimata e revisione ancora da esaminare. Etichette operative come “importato”, “proposto”, “verificato” e “contestato” descrivono lo stato del lavoro con maggiore precisione rispetto a un’approvazione complessiva. L’AI contribuisce assegnando priorità: record molto simili, conflitti tra campi e fonti prive di attribuzione salgono nella coda dei revisori.
La stessa disciplina riguarda le correzioni. Ogni modifica dovrebbe registrare valore precedente, valore nuovo, responsabile, data e motivazione. Un sistema capace di mostrare questa cronologia protegge l’archivio dalle revisioni opache e rende possibile tornare su decisioni prese con documentazione incompleta. L’autorevolezza cresce attraverso una manutenzione osservabile.
Un workflow pratico per collezioni disomogenee
Il flusso può iniziare con un’area di ingestione che conserva file, note e denominazioni originali. Da qui l’AI estrae campi candidati in uno schema rigido, preferibilmente con identificatori controllati e valori ammessi. Un validatore verifica la forma dei dati; un motore di confronto cerca record vicini attraverso nomi, seriali, checksum e relazioni già note.
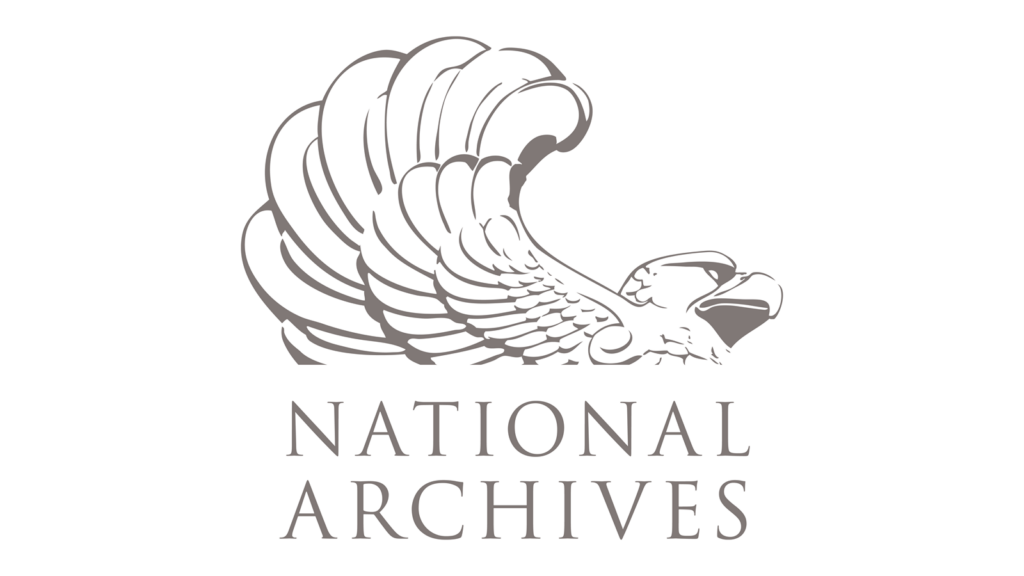
Il revisore riceve quindi un fascicolo compatto: proposta, evidenze, conflitti e possibili duplicati. Dopo l’approvazione, il sistema registra l’evento nel log e aggiorna gli indici di ricerca. Una nuova fonte può riaprire in seguito il record e produrre un’altra revisione. Questa architettura separa con chiarezza l’assistenza automatica, la decisione editoriale e la storia delle modifiche.
Servono inoltre regole specifiche per contenere gli errori tipici dei modelli. Il corpus interrogabile può essere limitato ai documenti ammessi dall’archivio. Ogni campo proposto può includere un riferimento preciso al passaggio da cui deriva. Le stringhe originali restano immutabili. Le fusioni tra record richiedono approvazione esplicita, perché la somiglianza semantica rischia di avvicinare porting, sequel, demo e versioni promozionali. Le tassonomie vanno riesaminate periodicamente: termini costruiti per una collezione iniziale possono diventare troppo generici quando il catalogo accoglie nuove piattaforme o nuovi tipi di materiale.
La qualità emerge nelle parti meno visibili
Per un archivio retro, il contributo più efficace dell’AI si trova nel lavoro ripetitivo che precede la consultazione: uniformare etichette, recuperare relazioni, ordinare anomalie e preparare confronti. La scheda pubblica resta il risultato di scelte verificabili, sostenute da fonti e competenze specifiche.
Un catalogo maturo dichiara ciò che conosce, ciò che deduce e ciò che attende ancora una conferma. Conserva le versioni dei propri record insieme alle versioni dei giochi. L’AI rende questo processo gestibile su larga scala; archivisti, redazioni e community gli attribuiscono significato storico e responsabilità.