Dalla preparazione degli script ai controlli sui token, l’AI può alleggerire una fan translation. Tono, contesto e compatibilità tecnica richiedono ancora responsabilità umane precise.
In una fan translation retro, una frase perfettamente leggibile può causare un overflow, alterare un comando oppure occupare una quantità di byte incompatibile con la struttura originale. La qualità linguistica arriva al giocatore attraverso puntatori, font, codici di controllo, finestre di dialogo e routine scritte per una macchina con vincoli molto specifici.
L’AI offre vantaggi concreti quando prepara il materiale, produce una prima bozza e individua incoerenze in grandi quantità di testo. Il suo spazio utile termina davanti alle decisioni che richiedono contesto narrativo, sensibilità culturale e conoscenza del funzionamento interno del gioco. Una pipeline efficace assegna ogni fase allo strumento più adatto e conserva una responsabilità editoriale riconoscibile.
La localizzazione comincia dalla struttura dei dati
Prima della traduzione esiste un lavoro di reverse engineering. I testi possono trovarsi in una ROM, in archivi proprietari, dentro file compressi oppure mescolati a istruzioni eseguibili. Occorre individuare tabelle dei caratteri, indirizzi, puntatori, terminatori e relazioni tra le stringhe. In alcuni giochi il nome del personaggio appare nello stesso blocco del dialogo; in altri viene richiamato da una variabile durante l’esecuzione.
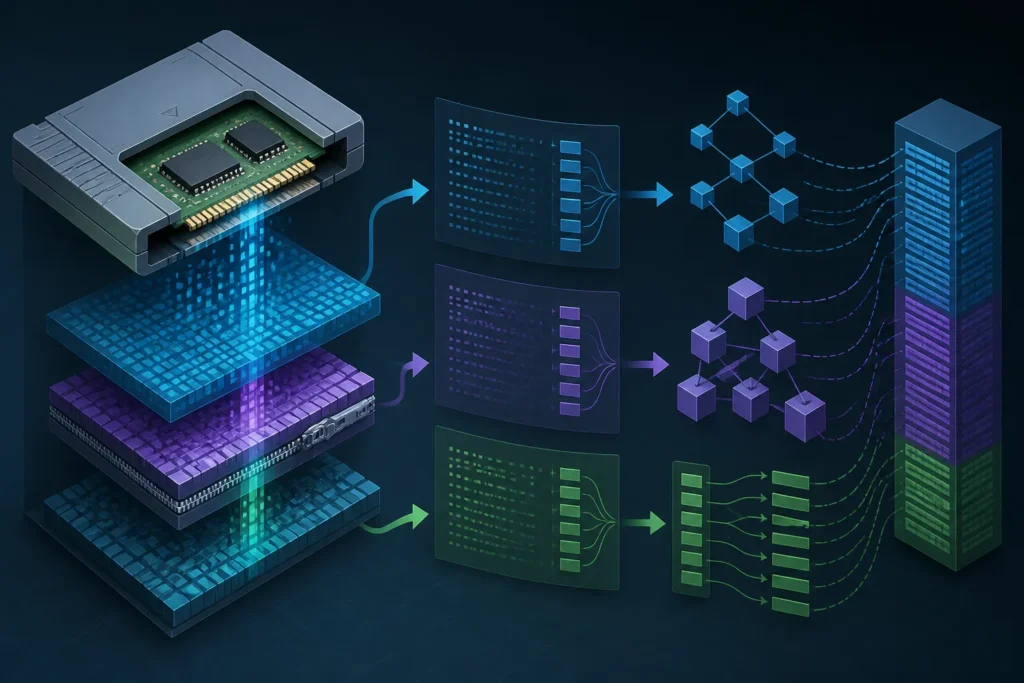
I repository tecnici dedicati alle traduzioni di Famicom, Game Boy Advance, Nintendo DS e JRPG mostrano pipeline sempre più organizzate attorno a estrazione reversibile, glossari e reinserimento controllato. Questi progetti hanno caratteristiche e livelli di maturità differenti, quindi vanno letti come segnali di un metodo in evoluzione. La direzione comune consiste nel trasformare lo script in un corpus strutturato, dove ogni riga conserva un identificatore e il collegamento con la sua posizione nel gioco.
Durante questa preparazione, un modello linguistico può classificare stringhe, suggerire quali appartengano ai menu e raggruppare formule ricorrenti. L’utilità cresce quando il dump contiene metadati affidabili: nome del file, identificativo del parlante, scena, stringhe precedenti e successive. Un elenco anonimo di frasi isolate genera facilmente interpretazioni plausibili e fuori contesto. La qualità del dato in ingresso determina quindi il valore di tutto il lavoro successivo.
La pretraduzione funziona come materiale di redazione
La prima accelerazione evidente riguarda la bozza iniziale. Descrizioni di oggetti, messaggi di sistema e formule ripetitive assorbono molte ore, soprattutto nei giochi di ruolo. Un LLM può produrre una base già ordinata, proporre varianti più brevi e segnalare termini ambigui. Il traduttore riceve così materiale da valutare al posto di una colonna vuota.
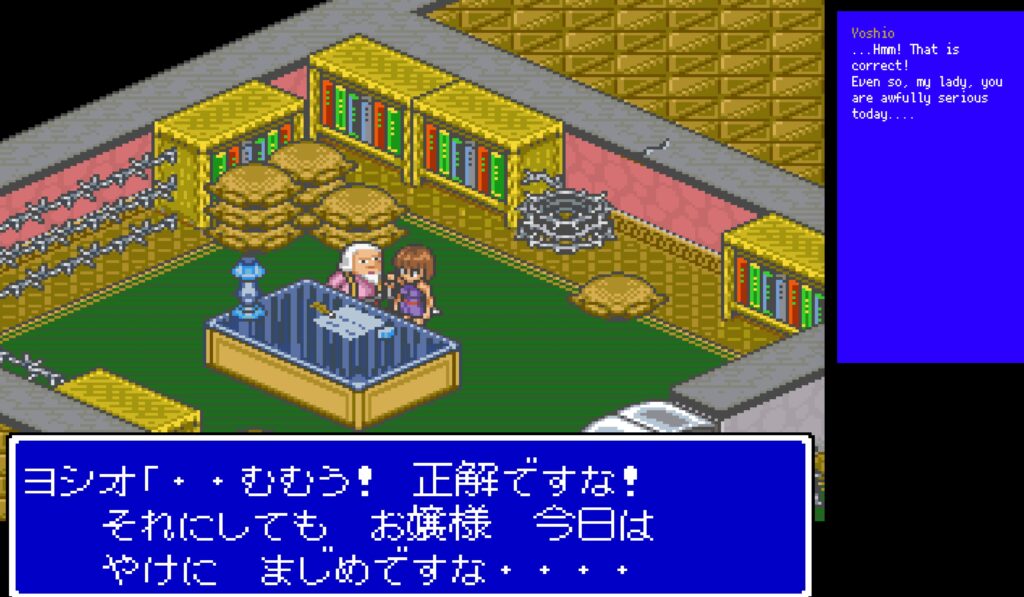
Questa fase diventa più affidabile attraverso un glossario approvato dalla squadra. Nomi propri, statistiche, classi, incantesimi e comandi dell’interfaccia devono mantenere la stessa forma lungo l’intero gioco. Il glossario stabilisce le scelte; il modello le applica e può evidenziare deviazioni. Una translation memory svolge una funzione complementare: recupera coppie già revisionate e consente di riutilizzare traduzioni certe. Il modello genera, la memoria documenta decisioni pregresse.
La distinzione ha conseguenze pratiche. Se “Guard” è già stato tradotto come “Difesa” nel menu di combattimento, la translation memory offre una corrispondenza verificata. In un dialogo, la stessa parola potrebbe essere un ordine rivolto a una sentinella. Il contesto assegna il significato e il revisore decide se la terminologia dell’interfaccia abbia davvero valore in quella scena.
Token e lunghezze richiedono controlli deterministici
Molte stringhe includono elementi che il giocatore vede attraverso i loro effetti: ritorni a capo, pause, cambi di colore, velocità del testo e variabili con il nome dell’eroe. Un token modificato durante la traduzione può produrre testo corrotto o interrompere la finestra di dialogo. La soluzione più sicura consiste nel sostituire questi elementi con placeholder protetti, tradurre la parte linguistica e ripristinare i codici originali durante il reinserimento.
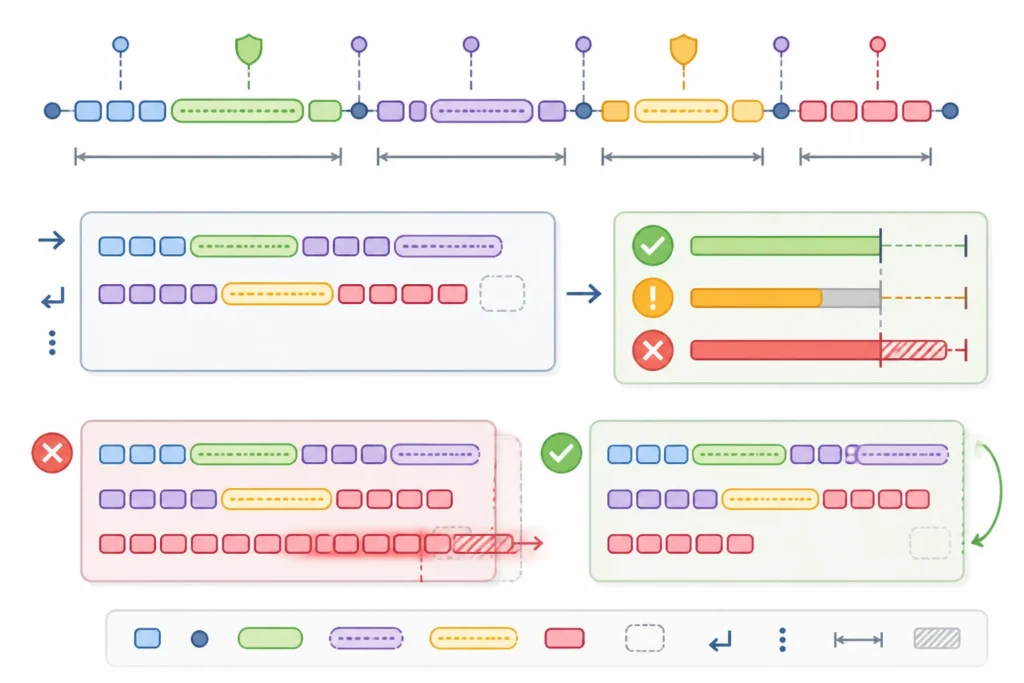
Qui entrano in gioco validatori tradizionali. Uno script può contare byte, confrontare token, verificare i caratteri ammessi e rifiutare una stringa troppo lunga. Questi controlli offrono risultati ripetibili e facilmente verificabili. L’AI può aggiungere un livello linguistico, per esempio rilevando una frase troncata o una variazione terminologica sospetta. Attribuire l’intera pipeline al modello confonde funzioni diverse e rende più difficile capire da dove provenga un errore.
Un flusso robusto tratta il reinserimento come un’operazione reversibile. La nuova build viene generata in un ambiente separato, sottoposta alle verifiche previste e scartata quando una regola fallisce. Al termine, la community può distribuire una patch che descrive le modifiche rispetto a una versione precisa del gioco. Questo formato separa il lavoro di localizzazione dai dati originali e facilita revisioni successive.
I limiti della macchina restano dentro ogni frase
Sulle piattaforme a 8 e 16 bit, lo spazio disponibile può dipendere da banchi di memoria, tabelle di puntatori e routine di decompressione. Il font spesso comprende un insieme ridotto di glifi costruiti su tile. L’introduzione di lettere accentate richiede spazio grafico, modifiche alla tabella dei caratteri e verifiche su tutte le schermate che utilizzano quel font. Anche una traduzione breve può superare la larghezza della finestra quando i caratteri hanno dimensioni differenti.
I sistemi a 32 e 64 bit offrono script generalmente più ampi, insieme a contenitori e formati più articolati. La maggiore capacità del supporto lascia comunque attivi vincoli di layout, memoria e codice. Menu disegnati per parole brevi, sottotitoli sincronizzati e texture contenenti testo impongono interventi distinti. Ogni proposta generata deve quindi passare attraverso la struttura concreta dell’interfaccia.
Il modello può suggerire sinonimi compatti, mentre la scelta definitiva richiede una prova a schermo. Abbreviare “Equipaggiamento” in un menu comporta valutazioni diverse rispetto alla riduzione di una battuta. La prima decisione riguarda leggibilità e coerenza dell’interfaccia; la seconda tocca voce del personaggio, ritmo e intenzione narrativa. La lunghezza rappresenta un dato tecnico con effetti editoriali.
Dove l’automazione deve cedere la scena
Umorismo, dialetti, doppi sensi e riferimenti culturali chiedono una lettura dell’opera nel suo insieme. Una battuta può richiamare un evento avvenuto ore prima, mentre un titolo onorifico può definire il rapporto tra due personaggi. Quando il dump omette il parlante o l’ordine delle scene, il modello tende a scegliere l’interpretazione statisticamente più probabile. La fluidità del risultato può nascondere l’errore.
Anche i nomi richiedono una decisione condivisa. Traslitterazione, adattamento e continuità con eventuali sequel producono effetti nei dialoghi, nei menu, nelle schermate di salvataggio e nella documentazione. La community deve fissare questi criteri in una guida di stile, spiegando le eccezioni e aggiornando il glossario quando emerge nuovo contesto.
Un’altra soglia critica compare quando la pretraduzione sembra correggere una riga confusa. Il problema potrebbe trovarsi nell’estrazione: byte saltati, terminatore interpretato male, tabella incompleta o ordine delle stringhe alterato. Una resa sorprendentemente elegante rischia di coprire il difetto. In questi casi il testo deve tornare alla fase tecnica, con un confronto diretto tra dump e dati originali.
Una pipeline con responsabilità visibili
Il lavoro può procedere attraverso passaggi chiaramente registrati. Il primo produce un corpus pulito e collegato alle risorse del gioco. Il secondo protegge token e caratteri speciali. La pretraduzione applica glossario e memoria, assegnando uno stato a ogni stringa. Seguono revisione linguistica, controllo editoriale e test della build. Ogni riga conserva così una storia: origine, proposta automatica, interventi umani e approvazione finale.
La verifica dentro il gioco rimane decisiva. Servono scene reali, percorsi alternativi, menu affollati e finestre con valori dinamici. Emulatori e strumenti di debug accelerano la ricerca; quando possibile, una prova sull’hardware previsto aiuta a controllare resa e comportamento effettivi. Screenshot, segnalazioni associate agli identificativi delle stringhe e build numerate rendono le correzioni gestibili anche in una squadra distribuita.
Le metriche utili riguardano stringhe ancora prive di revisione, token alterati, overflow, termini fuori glossario e scene già testate. La semplice percentuale di testo tradotto racconta poco della qualità raggiunta. Un progetto al 90 per cento può essere pronto per una verifica avanzata oppure contenere migliaia di righe ancora prive di contesto.
L’AI amplia il lavoro che una community può sostenere
Una squadra piccola può affidare al modello le formule ripetitive e concentrare le competenze migliori sulle scene più delicate. Il ROM hacker riceve segnalazioni più ordinate, il traduttore lavora su bozze contestualizzate, il revisore controlla decisioni terminologiche già raccolte. L’esperienza umana acquista valore perché viene indirizzata verso i passaggi con maggiore impatto.
La trasparenza completa il metodo. Le note del progetto possono indicare l’uso della pretraduzione, l’estensione della revisione, le parti ancora da testare e i criteri adottati per nomi e termini ricorrenti. Conservare output intermedi, glossari e regole di validazione rende la patch aggiornabile anche quando cambiano i collaboratori o gli strumenti.
Il posto più utile per l’AI si trova dietro le quinte: prepara, confronta, propone e segnala. La localizzazione prende forma definitiva quando una persona legge la frase nella sua scena, ne verifica il tono e la prova entro i limiti della macchina. È questa sequenza di responsabilità a trasformare una traduzione veloce in una fan patch capace di reggere il gioco completo.