Un flusso di lavoro pratico per trasformare manuali e materiali digitalizzati in documenti ricercabili, verificabili e adatti alla preservazione.
Una cartella piena di PDF può conservare migliaia di pagine e lasciare invisibile quasi tutto ciò che contengono. Titoli di sezione, comandi, codici di errore, nomi degli autori e riferimenti hardware restano intrappolati nelle immagini. Il passaggio decisivo consiste nel trasformare ogni scansione in un documento interrogabile, mantenendo un legame verificabile con la pagina originale.
OCR e strumenti di intelligenza artificiale accelerano diverse fasi di questo lavoro: riconoscono il testo, individuano la struttura della pagina, propongono correzioni e aiutano a compilare i metadati. La qualità archivistica dipende però dall’intero processo, dalla conservazione del file acquisito fino alla registrazione degli interventi umani.
Il master viene prima dell’OCR
La scansione originale rappresenta la fonte visiva dalla quale discendono tutte le elaborazioni. Conviene conservarla come master separato, con la migliore qualità disponibile e in un formato adatto alla conservazione, come TIFF o PDF costruiti senza ricompressioni distruttive. Ritaglio, rotazione, regolazione dei livelli e riconoscimento testuale possono essere applicati a copie di lavorazione.
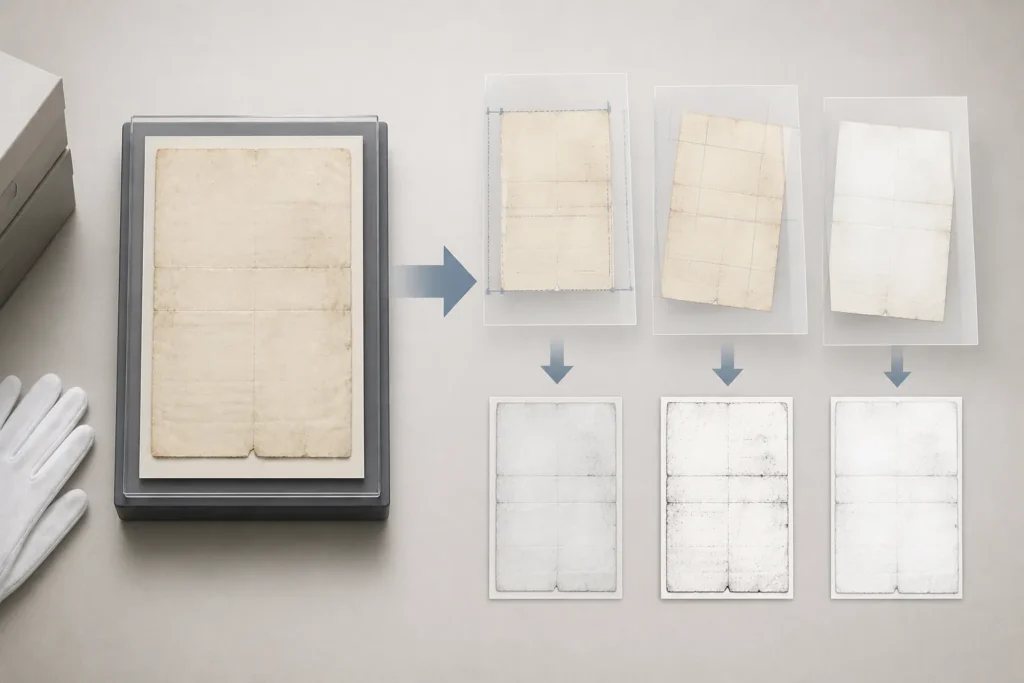
Questa separazione protegge dettagli che un trattamento automatico potrebbe eliminare: una nota a matita, la trama di una retinatura o il bordo di un inserto ripiegato. Permette inoltre di ripetere l’OCR quando arrivano modelli linguistici più accurati, conservando intatto il materiale acquisito.
Già durante la scansione serve una struttura coerente. Copertine, pagine interne e allegati devono seguire una numerazione stabile. Le pagine mancanti o duplicate vanno registrate, così come eventuali errori presenti nell’esemplare fisico. Un identificatore comune collega il master, le versioni elaborate e i relativi metadati.
Preparare la pagina per il riconoscimento
Molti errori attribuiti all’OCR nascono prima del riconoscimento. Pagine inclinate, curvature vicino alla rilegatura e testo visibile in trasparenza confondono la segmentazione. I manuali di giochi e computer aggiungono altre difficoltà: colonne, schermate, tabelle e caratteri decorativi convivono spesso nello stesso impaginato.
Il preprocessing può correggere orientamento, ritaglio e contrasto. La suddivisione di una doppia pagina in due immagini distinte aiuta a ricostruire l’ordine di lettura. Ogni regolazione va calibrata sul documento: un filtro aggressivo può assottigliare i caratteri, cancellare accenti o fondere le lettere con una retinatura.
Gli strumenti basati su AI risultano utili per raddrizzare pagine curve, separare testo e illustrazioni o ridurre disturbi ricorrenti. Gli interventi generativi richiedono particolare cautela. Un sistema capace di ricostruire un bordo può anche inventare la forma plausibile di una lettera. Per questo motivo la pagina ripulita funziona bene come derivato destinato alla lettura, mentre il master conserva l’evidenza visiva originale.
Scegliere l’OCR in base al documento
Una copertina con poche scritte richiede un rilevamento diverso da una pagina densa articolata in colonne. Anche i servizi contemporanei distinguono fra riconoscimento generico del testo e analisi documentale, orientata alla struttura dell’impaginato. La seconda modalità è spesso più adatta a libretti tecnici, cataloghi e guide strategiche.
Tesseract offre un ambiente aperto, multilingue e integrabile in lavorazioni automatizzate. La sua configurazione rende ripetibili i passaggi e permette di produrre testo piano oppure output dotati di informazioni sulla posizione delle parole. ABBYY FineReader concentra molte funzioni nell’analisi del layout e nella creazione di PDF ricercabili. Google Cloud Vision propone modalità distinte per immagini semplici e documenti densi. Sono approcci diversi, da valutare attraverso un campione rappresentativo del proprio archivio.
La lingua selezionata incide direttamente sul risultato. Un manuale può contenere istruzioni in italiano, comandi inglesi e termini giapponesi traslitterati. Conviene identificare le aree linguistiche e conservare i termini tecnici nella forma attestata dalla pagina. Dizionari personalizzati possono aiutare con nomi di chipset, periferiche e software, soprattutto quando ricorrono lungo l’intero documento.
Dove l’AI offre un aiuto concreto
Dopo una prima estrazione, un modello linguistico può individuare sequenze sospette, ricomporre parole spezzate a fine riga e proporre una punteggiatura coerente. Questi suggerimenti acquistano valore quando restano collegati all’immagine e vengono presentati come ipotesi di correzione. La forma stampata conserva l’autorità documentaria.
La classificazione automatica può distinguere copertine, indici e pagine pubblicitarie, facilitando la creazione di sezioni consultabili. Un sistema può anche estrarre candidati per i metadati, come titolo, lingua e numero di edizione. L’operatore verifica poi ogni dato sul documento e lo associa al campo corretto.
La traduzione assistita apre l’accesso a manuali disponibili in lingue poco conosciute dalla comunità di riferimento. Il flusso più trasparente conserva tre livelli: OCR grezzo, testo corretto nella lingua originale e traduzione revisionata. Ogni livello riceve una propria versione e rimane allineato alla pagina. Terminologia interna, abbreviazioni e limiti hardware richiedono una revisione competente, perché una traduzione fluida può alterare il significato di un comando o di un avvertimento tecnico.
Il controllo qualità deve cercare gli errori costosi
La percentuale generale di caratteri riconosciuti racconta una parte limitata della qualità. Un testo quasi perfetto può contenere un errore decisivo nel nome di un file o nell’indirizzo di memoria. Nei materiali retro meritano attenzione prioritaria codici, tabelle e sequenze di comandi.
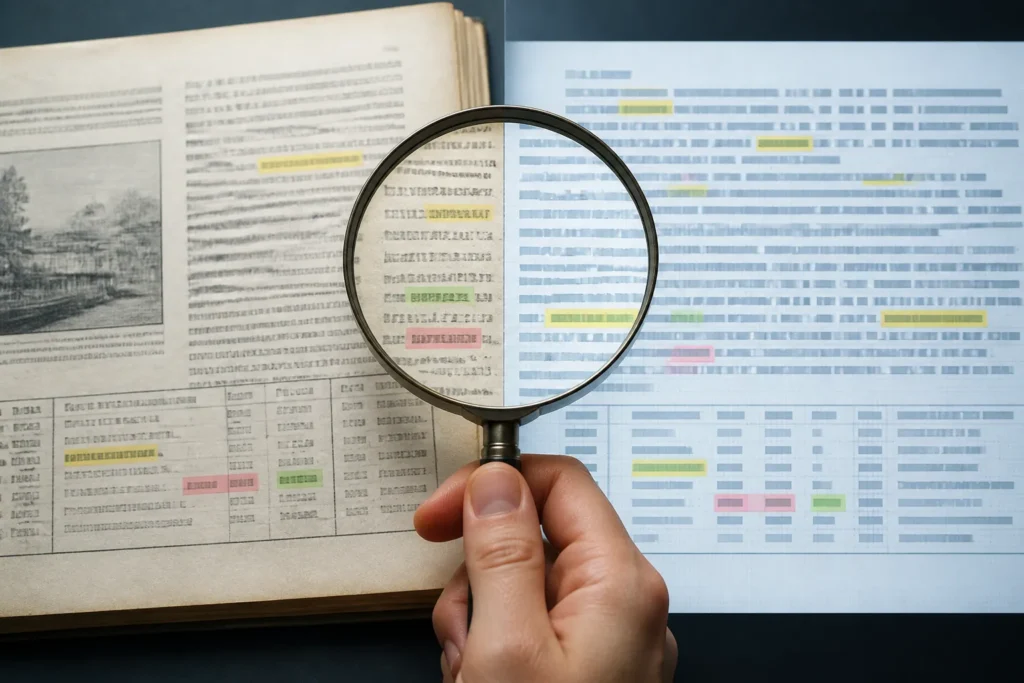
- Selezionare un campione che includa pagine lineari, impaginati complessi e scansioni deteriorate.
- Confrontare con l’immagine i nomi propri, le sigle hardware e i valori numerici.
- Verificare l’ordine di lettura nelle colonne e il corretto collegamento fra didascalie e figure.
- Controllare la completezza del documento, comprese pagine bianche dichiarate e allegati.
- Registrare correzioni, strumenti utilizzati e data di lavorazione.
Il campionamento offre una misura iniziale e aiuta a calibrare il processo. Documenti destinati alla citazione, alla traduzione o alla ricostruzione tecnica richiedono una revisione più estesa. Le aree a bassa confidenza indicate da alcuni motori OCR possono indirizzare il lavoro umano, pur restando un segnale statistico da verificare sulla pagina.
I metadati trasformano i file in un archivio
La ricerca nel testo permette di trovare una parola; i metadati spiegano che cosa si sta consultando. La descrizione dovrebbe identificare almeno il documento, la piattaforma e la lingua. Edizione, editore e provenienza dell’esemplare aggiungono il contesto necessario per distinguere varianti apparentemente uguali.
Servono poi dati tecnici sul file e informazioni sul processo. Formato, dimensioni e identificatore descrivono l’oggetto digitale. Gli eventi di acquisizione, elaborazione e correzione documentano la sua storia. Il modello PREMIS della Library of Congress offre un riferimento per registrare oggetti, eventi e agenti coinvolti nella preservazione digitale.
Questa tracciabilità diventa preziosa quando un archivio cresce. Una nuova esecuzione dell’OCR può essere confrontata con la precedente, mentre una correzione editoriale rimane attribuibile. Anche l’incertezza può essere descritta: una data parziale o un’edizione presunta acquistano utilità se il relativo grado di sicurezza è esplicito.
Produrre formati adatti a usi diversi
Il PDF con layer testuale invisibile conserva l’aspetto della scansione e rende possibili ricerca, selezione e copia. Il testo piano facilita l’indicizzazione generale. Formati strutturati come hOCR e ALTO mantengono informazioni sulla posizione dei contenuti, mentre il TSV si presta a elaborazioni e controlli automatizzati.
Un pacchetto archivistico essenziale può comprendere:
- il master della scansione;
- una copia ripulita per la consultazione;
- il testo OCR e gli eventuali output strutturati;
- i metadati descrittivi e tecnici;
- un registro delle lavorazioni e delle correzioni.
L’interfaccia di consultazione dovrebbe riportare ogni risultato alla pagina corrispondente. Chi cerca un’istruzione può così leggere il testo estratto, aprire subito l’immagine e valutare grafica, impaginazione e contesto. Questa relazione rende l’OCR uno strumento di accesso affidabile anziché una trascrizione isolata.
Un workflow sostenibile parte da un piccolo campione
Prima di elaborare un’intera collezione conviene scegliere alcune pubblicazioni rappresentative. Il campione rivela quali lingue, layout e difetti ricorrono davvero. Da questa prova emergono il profilo di preprocessing, il motore OCR più adatto e il livello di revisione necessario.
Il processo può quindi diventare ripetibile: acquisizione, preparazione, riconoscimento, verifica, metadatazione ed esportazione. Versioni e registri mantengono leggibile ogni trasformazione. L’automazione assorbe i passaggi seriali; la competenza umana si concentra sulle ambiguità che incidono sul significato.
Un archivio maturo conserva la pagina come oggetto storico e rende interrogabile ciò che vi è stampato. La combinazione di master integri, OCR verificato, metadati coerenti e derivati ben identificati permette a manuali e materiali di corredo di entrare in nuove ricerche, traduzioni e attività di documentazione senza perdere la propria storia editoriale.