Un metodo operativo per ordinare documenti, distinguere fatti e ipotesi, gestire le versioni e trasformare il materiale verificato in una bozza leggibile.
Una patch può avere tre date diverse: quella del file distribuito, quella indicata nel readme e quella dell’annuncio pubblicato sul forum. A queste si aggiungono mirror incompleti, pagine archiviate, revisioni silenziose e commenti che attribuiscono il lavoro a persone differenti. In un dossier sul retro attivo, l’errore nasce spesso durante l’ordinamento del materiale, molto prima della scrittura.
Un assistente AI può ridurre il tempo impiegato per confrontare documenti, estrarre nomi e raggruppare informazioni correlate. Il controllo editoriale rimane legato a una catena verificabile: ogni affermazione deve conservare il collegamento con la propria origine, ogni dubbio deve restare visibile e ogni revisione del dossier deve poter essere ricostruita.
Il dossier comincia da una mappa delle fonti
Consegnare all’assistente una cartella piena di PDF, pagine salvate, trascrizioni e appunti produce facilmente una sintesi scorrevole e fragile. Prima dell’elaborazione serve un inventario. Ogni documento riceve un identificatore stabile e una scheda minima con titolo, autore o organizzazione, data dichiarata, data di acquisizione, indirizzo di provenienza, formato e ruolo nel dossier.
Il ruolo chiarisce che cosa può sostenere quella fonte. Un readme allegato a una traduzione documenta la versione pubblicata, i crediti dichiarati e le istruzioni d’installazione. Una discussione su un forum può ricostruire il percorso di sviluppo, con un grado di affidabilità legato all’identità dei partecipanti e alla vicinanza temporale agli eventi. Una pagina di catalogo descrive il prodotto distribuito; difficilmente basta per attribuire una tecnica a uno specifico programmatore.
Questa classificazione evita che documenti diversi acquisiscano lo stesso peso durante la sintesi. Conviene inoltre conservare il file originale, l’eventuale testo ottenuto tramite OCR e una nota sulle correzioni manuali. Numeri di versione, nomi propri e sigle hardware sono tra gli elementi che l’OCR altera più facilmente, proprio quelli decisivi in articoli su patch, prototipi e compatibilità.
Recuperare un passaggio significa ancora doverlo verificare
Gli strumenti di ricerca semantica applicati a una raccolta di file risultano utili quando il corpus è ampio. Permettono di ritrovare riferimenti espressi con parole differenti, accostare documenti che citano la stessa revisione e individuare sezioni pertinenti dentro manuali molto lunghi. Il risultato indica dove guardare. La verifica richiede la lettura del passaggio recuperato e del suo contesto.
Una frase isolata può riferirsi a una versione precedente, a una funzione prevista oppure a un test fallito. Per questo ogni estrazione dovrebbe includere il documento, la pagina o la sezione, una breve citazione testuale e l’identificatore della fonte. Se il sistema restituisce una sintesi priva di questi riferimenti, il materiale resta una traccia di ricerca e non entra tra i fatti consolidati.
Anche il perimetro va dichiarato. L’assistente deve sapere quali file può usare, quale intervallo cronologico interessa e quali elementi richiedono conferma. Una regola semplice migliora l’intero processo: quando il corpus non contiene la risposta, il campo corrispondente rimane vuoto oppure assume lo stato “da verificare”. Una lacuna esplicita costa meno di una ricostruzione plausibile inserita per continuità narrativa.
Uno schema stabile rende visibili dubbi e conflitti
Gli output strutturati, per esempio quelli vincolati da JSON Schema, trasformano la prima analisi in materiale controllabile. Al posto di una lunga risposta discorsiva, l’assistente compila record con campi prevedibili. Una possibile unità del dossier comprende l’affermazione, la sua classe, le fonti associate, l’evidenza testuale, le entità coinvolte, le date, i conflitti rilevati e lo stato della verifica.
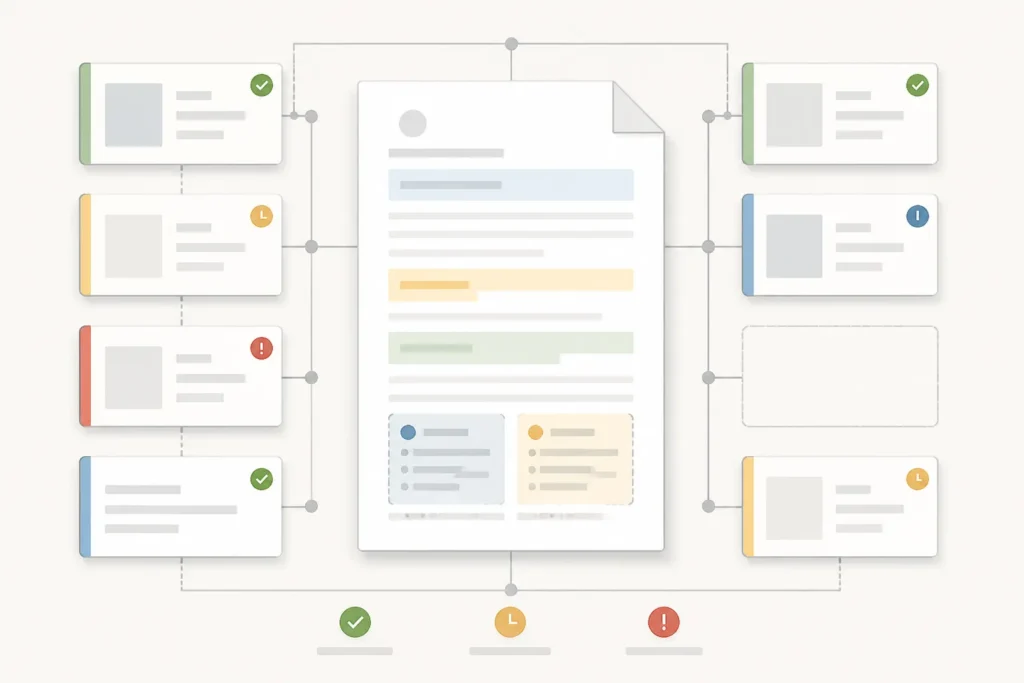
La struttura svolge una funzione editoriale concreta. Se una data compare in un record privo di fonte, l’anomalia emerge subito. Se due readme attribuiscono numeri di versione differenti allo stesso archivio, il campo dedicato ai conflitti conserva entrambe le indicazioni. Il redattore può quindi risalire ai file, controllare timestamp e checksum disponibili, cercare una copia ulteriore oppure formulare il testo finale con la cautela necessaria.
Il quadro di gestione del rischio proposto dal NIST insiste su documentazione, trasparenza e supervisione lungo il ciclo di utilizzo dei sistemi AI. Trasposto nel lavoro editoriale, questo approccio suggerisce di registrare operazioni e decisioni: quali documenti sono entrati nel corpus, quali istruzioni hanno guidato l’estrazione, quali risultati sono stati corretti e chi ha approvato la versione consolidata.
Fatto, ipotesi e contesto richiedono spazi separati
Un dossier efficace mantiene almeno tre livelli. Il primo contiene fatti verificati attraverso una fonte adeguata: data di pubblicazione dichiarata, piattaforma prevista, autore accreditato, requisiti di una patch. Il secondo raccoglie ipotesi di lavoro, comprese le attribuzioni probabili e le cronologie ricostruite da indizi parziali. Il terzo conserva il contesto interpretativo necessario a spiegare il significato tecnico o storico del materiale.
Si può prendere come esempio una traduzione amatoriale per un gioco a 32 bit. Il file di distribuzione e il readme documentano la revisione disponibile. I messaggi degli sviluppatori aiutano a ricostruire strumenti, problemi di codifica e modifiche alla grafica. Il confronto tra immagini del gioco originale e della versione tradotta consente di descrivere il risultato. L’idea che un ritardo dipenda da un limite specifico del formato grafico resta un’ipotesi finché una testimonianza o una prova tecnica la sostiene.
L’assistente può classificare queste unità e segnalare formulazioni troppo assertive rispetto alle evidenze. La decisione finale spetta al redattore, che valuta anche la qualità della fonte. Due pagine che ripetono la stessa informazione possono derivare da un’unica dichiarazione originaria; contarle come conferme indipendenti creerebbe una sicurezza apparente.
I controlli sensibili vanno assegnati in anticipo
Attribuzioni, date, citazioni, numeri di versione e compatibilità hardware meritano una revisione umana obbligatoria. Sono dati brevi, facili da riportare in modo credibile e capaci di cambiare il significato dell’articolo. Un suffisso omesso può confondere due revisioni di una scheda; una regione trascurata può rendere errata una procedura; una citazione parafrasata può trasformare una possibilità in una dichiarazione.
La lista dei controlli nasce insieme al dossier. Per un progetto homebrew comprenderà piattaforma reale di destinazione, configurazioni testate, stato dello sviluppo e crediti. Per un restauro digitale includerà provenienza degli asset, interventi effettuati e relazione con il materiale originale. Per una patch serviranno versione di base, formato dell’immagine, hash eventualmente pubblicati e dipendenze tecniche.
Questo passaggio definisce anche il confine operativo dell’assistente. L’AI prepara tabelle comparative, individua discrepanze e propone domande di verifica. Il redattore apre le fonti, controlla i dati sensibili e registra l’esito. La responsabilità rimane così associata a un’azione osservabile anziché a una generica rilettura finale.
Il versioning protegge il lavoro già verificato
Un dossier cambia mentre arrivano nuovi documenti. Trattarlo come un artefatto versionato permette di distinguere raccolta, revisione e consolidamento. La logica di commit e tag usata da Git offre un modello utile anche quando il gruppo lavora con strumenti più semplici: ogni modifica significativa riceve una descrizione, le bozze hanno nomi coerenti e una versione congelata diventa la base dell’articolo.
Conviene separare i file originali, i testi normalizzati, le estrazioni AI e le note editoriali. La bozza pubblica deriva da una release identificabile del dossier. Se una fonte viene corretta in seguito, il confronto tra versioni mostra quali paragrafi richiedono un aggiornamento. Si evita così che un’informazione nuova entri silenziosamente in una sintesi già approvata.
Anche i prompt fanno parte della documentazione. Conservare istruzioni, schema richiesto e parametri essenziali aiuta a capire perché due elaborazioni abbiano prodotto risultati differenti. La ripetibilità assoluta resta difficile con sistemi generativi; la tracciabilità delle condizioni di lavoro rende comunque la revisione molto più solida.
Dal materiale consolidato alla bozza leggibile
La scrittura funziona meglio in passaggi distinti. Il primo costruisce una scaletta usando le unità verificate e indica dove inserire il contesto. Il secondo sviluppa la prosa conservando gli identificatori delle affermazioni. Il terzo confronta ogni frase fattuale con il registro del dossier. In questa fase l’assistente può segnalare dati comparsi nella bozza senza una corrispondenza nel materiale approvato.
La leggibilità nasce dopo la verifica. Citazioni, dettagli tecnici e cronologia vengono distribuiti secondo il ragionamento dell’articolo, invece di seguire l’ordine casuale con cui sono state raccolte le fonti. Le ipotesi mantengono formule coerenti con il loro grado di certezza. Il contesto editoriale spiega perché una traduzione, un firmware recuperato o una nuova revisione hardware meritino attenzione.
Una checklist minima prima della consegna
- Ogni affermazione verificabile possiede almeno un riferimento rintracciabile.
- Le fonti derivate rimandano, quando disponibile, al documento originario.
- Fatti, ipotesi e interpretazioni hanno etichette e formulazioni coerenti.
- Date, nomi, versioni, citazioni e compatibilità hanno ricevuto un controllo umano.
- I conflitti tra documenti restano registrati anche dopo la scelta editoriale.
- La bozza deriva da una versione congelata e identificata del dossier.
- Le informazioni prive di sostegno sono state rimosse oppure indicate come questioni aperte.
In questo flusso l’efficienza deriva dalla divisione chiara dei compiti. L’assistente attraversa rapidamente grandi quantità di materiale, applica uno schema comune e porta in superficie incongruenze che rischierebbero di restare disperse tra file e appunti. Il redattore stabilisce il valore delle fonti, risolve i passaggi sensibili e assume la responsabilità della formulazione pubblicata. Il dossier diventa così una struttura consultabile e aggiornabile, capace di sostenere l’articolo anche quando archivi, patch e ricostruzioni continuano a evolvere.