Un metodo per leggere manuali, inserti e mappe come parti operative del gioco, usando OCR e AI per riconoscere variazioni significative tra edizioni diverse.
Due edizioni dello stesso gioco possono guidare il giocatore in modi diversi. Un comando tradotto con maggiore precisione, un avviso aggiunto vicino alla procedura di salvataggio o una legenda ridisegnata cambiano il modo in cui il software viene compreso e utilizzato. Il confronto tra manuali permette di recuperare queste variazioni, spesso invisibili osservando esclusivamente il programma in esecuzione.
L’intelligenza artificiale rende praticabile l’analisi di documenti estesi, scansioni imperfette e impaginazioni differenti. Il suo contributo più utile consiste nell’allineare materiali eterogenei e nel portare le discrepanze all’attenzione del ricercatore. La loro interpretazione richiede ancora il controllo delle edizioni, delle immagini originali e del comportamento effettivo del gioco.
La parte dell’interfaccia conservata nella scatola
Molti giochi delle generazioni 32 e 64 bit distribuivano la propria interfaccia tra schermo, controller e documentazione cartacea. Il manuale spiegava combinazioni di tasti, indicatori, inventari e procedure di salvataggio; gli inserti raccoglievano avvisi o comandi rapidi; mappe e schede di riferimento organizzavano informazioni da consultare durante la partita. La pagina svolgeva quindi una funzione concreta: preparava un gesto, attribuiva un significato a un simbolo e stabiliva il vocabolario con cui leggere il gioco.
Questa funzione emerge con particolare chiarezza quando si mettono fianco a fianco edizioni regionali, ristampe o versioni destinate a piattaforme differenti. Una tabella dei controlli può riflettere la disposizione di un altro controller. Un glossario localizzato può cambiare il rapporto tra il nome stampato e quello mostrato a schermo. Una nota inserita in una tiratura successiva può chiarire una procedura descritta male nella prima edizione. Ogni variazione racconta come l’editore prevedeva che il pubblico avrebbe appreso il sistema.
Costruire un corpus prima di avviare il confronto
Il lavoro comincia dall’identificazione dei materiali. Regione, piattaforma, lingua, codice di stampa, anno indicato e numero di pagine formano la scheda minima di ciascun esemplare. Vanno registrati anche allegati mancanti, pagine sostituite e annotazioni del proprietario. Due PDF con un titolo identico possono provenire da tirature diverse oppure dalla stessa copia digitalizzata e ricompressa più volte.
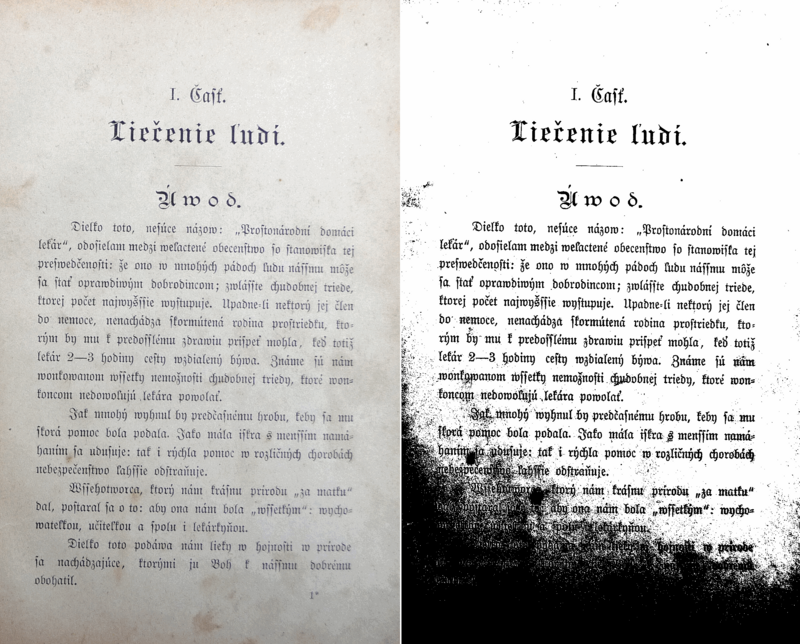
Le scansioni originali devono rimanere separate dai file derivati. Rotazione, ritaglio, aumento del contrasto e rimozione del rumore migliorano spesso il riconoscimento ottico, mentre una pulizia aggressiva può cancellare punteggiatura, linee sottili e piccoli simboli. La documentazione di Tesseract richiama l’attenzione proprio su qualità dell’immagine, inclinazione, bordi e segmentazione della pagina. Il testo ottenuto tramite OCR costituisce dunque un livello di lavoro collegato alla scansione, con la possibilità di tornare in ogni momento alla fonte visiva.
Una numerazione stabile delle pagine facilita ogni passaggio successivo. Conviene distinguere la pagina fisica, l’eventuale numero stampato e la posizione nel file digitale. Questa precauzione evita riferimenti ambigui quando una copertina viene conteggiata in un PDF e omessa nell’altro.
Tre livelli da leggere insieme
Il testo riconosciuto
Al primo livello l’AI può allineare paragrafi equivalenti, individuare parole aggiunte e confrontare tabelle dei comandi. L’allineamento letterale dovrebbe precedere il confronto semantico. Una parafrasi automatica tende infatti ad avvicinare frasi che trasmettono un’idea simile, perdendo differenze minime come «premere» e «tenere premuto». In un manuale operativo, una singola sfumatura verbale può descrivere due azioni distinte.
La struttura della pagina
Il secondo livello riguarda la relazione tra testo, immagini e posizione. Un avviso collocato accanto alle istruzioni di salvataggio possiede una visibilità diversa rispetto alla stessa frase relegata nelle note finali. Frecce, riquadri, icone del controller e didascalie richiedono una lettura spaziale. L’OCR lineare può mescolare colonne o associare una legenda all’immagine sbagliata; i modelli capaci di analizzare il layout aiutano a proporre collegamenti, che vanno verificati sulla pagina.
La conseguenza per il giocatore
Il terzo livello traduce la discrepanza in una domanda concreta: quale azione, precauzione o interpretazione cambia? Una nuova denominazione può avere valore terminologico. Un tasto differente altera direttamente l’uso del gioco. Lo spostamento di un’immagine può derivare dalla nuova impaginazione e conservare lo stesso contenuto. Questa classificazione impedisce di attribuire identico peso a ogni differenza rilevata dalla macchina.
Separare varianti, refusi e rumore digitale
Una comparazione affidabile può organizzare i risultati in quattro famiglie. Le differenze operative riguardano controlli, regole, sequenze e procedure. Le variazioni editoriali comprendono terminologia, localizzazione e avvisi regionali. Le modifiche materiali interessano formato, impaginazione e qualità di stampa. Gli artefatti di acquisizione derivano infine da polvere, pieghe, retinatura tipografica o compressione dell’immagine.
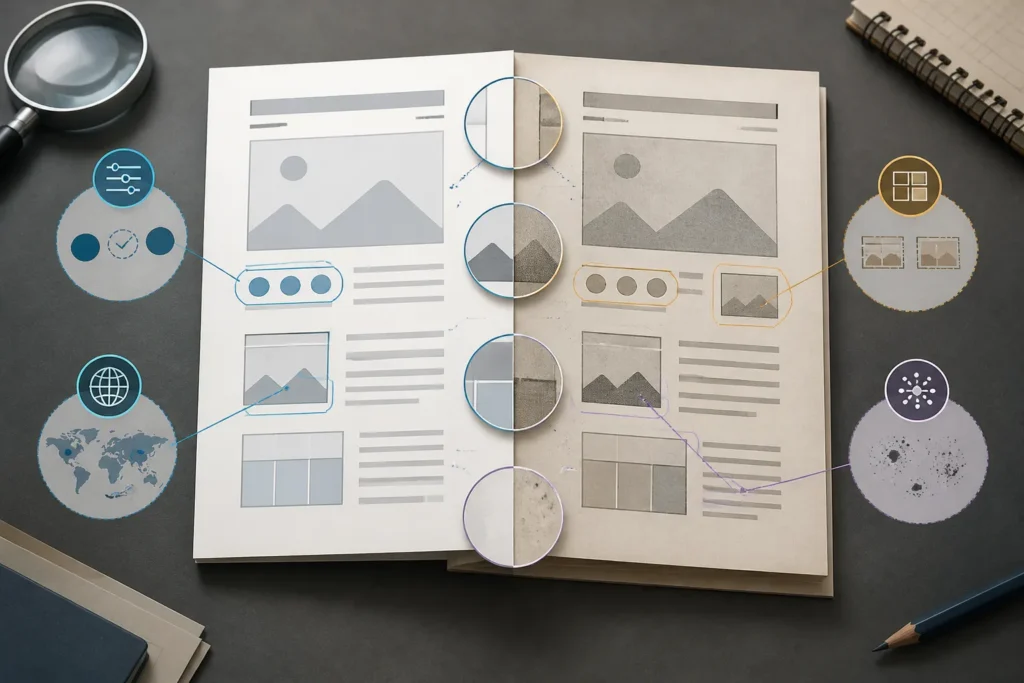
L’AI può assegnare una prima etichetta e un livello di confidenza. La decisione editoriale richiede prove visibili. Una parola deformata nello stesso modo in scansioni indipendenti può appartenere alla stampa; un carattere ambiguo presente in un unico file suggerisce un problema di digitalizzazione. La coerenza interna offre un altro controllo: se il glossario, la schermata e la tabella adottano lo stesso termine, la variante acquista maggiore solidità.
Anche il concetto di refuso richiede cautela. Una forma apparentemente errata può riprodurre una convenzione adottata dall’edizione locale oppure il nome mostrato da una specifica build. Il confronto con il software, eseguito nella regione e nella revisione corrispondenti, permette di capire se il manuale anticipa il comportamento del gioco, lo descrive in modo impreciso o conserva una terminologia precedente.
Assegnare all’AI compiti verificabili
Un flusso efficace divide il lavoro in operazioni circoscritte. L’OCR produce una trascrizione con indicatori di incertezza. Un secondo passaggio allinea sezioni equivalenti. L’analisi del layout collega didascalie, figure e riquadri. Il confronto semantico raggruppa le discrepanze secondo il loro possibile effetto. Per ogni risultato conviene conservare pagina, ritaglio, trascrizione delle due versioni, categoria proposta e osservazione umana.
Le istruzioni date al modello dovrebbero vietare il completamento creativo delle parti illeggibili. Un campo come «testo incerto» o «simbolo da verificare» è più utile di una ricostruzione fluida priva di riscontro. Lo stesso criterio vale per le traduzioni: prima si registra la formulazione originale, poi si aggiunge una resa di servizio. In questo modo abbreviazioni insolite e scelte terminologiche restano disponibili per analisi successive.
Il confronto tra più sistemi OCR può essere utile sulle pagine difficili. Una concordanza fra trascrizioni aumenta la fiducia, mentre risultati divergenti indicano il bisogno di consultare la scansione. Le demo e i comparatori raccolti nella categoria OCR di Hugging Face mostrano quanto questo approccio sia ormai accessibile. La quantità di strumenti disponibili rende ancora più importante conservare nome del software, versione, impostazioni e data dell’elaborazione.
Un caso esemplificativo: tre discrepanze, tre verifiche
Si considerino due manuali regionali dello stesso ipotetico gioco per una console a 32 bit. Il sistema rileva tre differenze: una tabella usa «premere» dove l’altra usa «tenere premuto»; un avviso sul salvataggio compare in una singola edizione; la legenda della mappa assegna due nomi diversi alla stessa icona.
La prima discrepanza richiede una prova nel gioco con la build corretta, perché riguarda l’esecuzione del comando. La seconda va confrontata con la procedura di memorizzazione e con eventuali fogli aggiuntivi presenti nella confezione. La terza richiede di controllare il termine visualizzato a schermo e il resto del glossario. Il sistema automatico ha trovato tre anomalie testuali; l’indagine le trasforma in ipotesi distinte sulla localizzazione, sulla sicurezza d’uso e sulla coerenza dell’interfaccia.
Conservare il risultato insieme alla documentazione
Il prodotto finale può assumere la forma di una scheda comparativa, collegata ai file di origine e corredata da miniature delle aree interessate. Trascrizioni, correzioni manuali e rapporti di allineamento dovrebbero restare distinguibili. Un checksum dei file, la provenienza della scansione e i dati dell’esemplare permettono inoltre di ricostruire il percorso seguito.
La cornice proposta dalla Library of Congress per software e videogiochi aiuta a considerare formati, metadati e documentazione come elementi connessi della conservazione. Nel caso dei manuali, preservare la pagina significa mantenere anche il rapporto tra istruzione, grafica e oggetto software. Una trascrizione pura rende il testo ricercabile; la scansione conserva l’interfaccia editoriale attraverso cui quel testo arrivava al giocatore.
L’output dell’AI funziona come indice di lavoro e mappa delle discrepanze. La fonte resta il materiale identificato, osservabile e riproducibile. Seguendo questa distinzione, la tecnologia accelera una lettura che altrimenti richiederebbe molte ore e lascia intatta la responsabilità critica di chi attribuisce significato ai cambiamenti.
Trattare il manuale come interfaccia restituisce alla documentazione il suo ruolo originario. Le pagine insegnavano a muoversi, interpretare simboli e proteggere i progressi; edizioni diverse potevano insegnare queste operazioni in modi differenti. Rendere tali variazioni ricercabili significa conservare una parte dell’esperienza di gioco che il codice, da solo, racconta con difficoltà.